本地 LLM 应用的电子数据取证
为什么值得关注
过去两年,本地大模型应用完成了从极客玩具到大众软件的转变:Ollama 让“一条命令跑模型”成为现实,Cherry Studio、AnythingLLM、LM Studio 这类客户端把对话、知识库、智能体做到了开箱即用,普通用户不需要任何技术背景就能在自己的电脑上跑起几十亿参数的模型。相应地,涉案设备上出现这类应用的频率正在快速上升——文本生成、语言翻译、资料整理,都是高频使用场景。
伴随普及的是一个普遍的认知误区:“不联网 = 无痕”。这个前提恰恰站不住脚:模型动辄几百 MB 到几十 GB,下载必经网络;对话要么写进本地的数据库文件,要么留在内存和日志里。所谓离线,只是没有云端的备份,不代表没有本地的内容。
对取证人员来说,还有一个好消息:这类应用几乎全部采用“明文文件 + SQLite 数据库”的朴素存储,没有全盘加密、没有私有压缩格式,正是传统文件/数据库取证的舒适区——工具不变、套路不变,变的只是对象。
本文按“四层痕迹”的框架,逐一介绍主流本地 LLM 应用在 Windows 系统上的取证点。文中路径与结构基于 2026 年 9 月前的公开版本整理,这类应用迭代很快,现场处置请以“先枚举、再识别、后解析”的方法论应对版本差异。
一、痕迹有哪些?
面对一个装满 AI 应用的系统,不要一上来就翻某个文件夹。先按“分层”建立检查框架,每一层回答一个独立的问题:
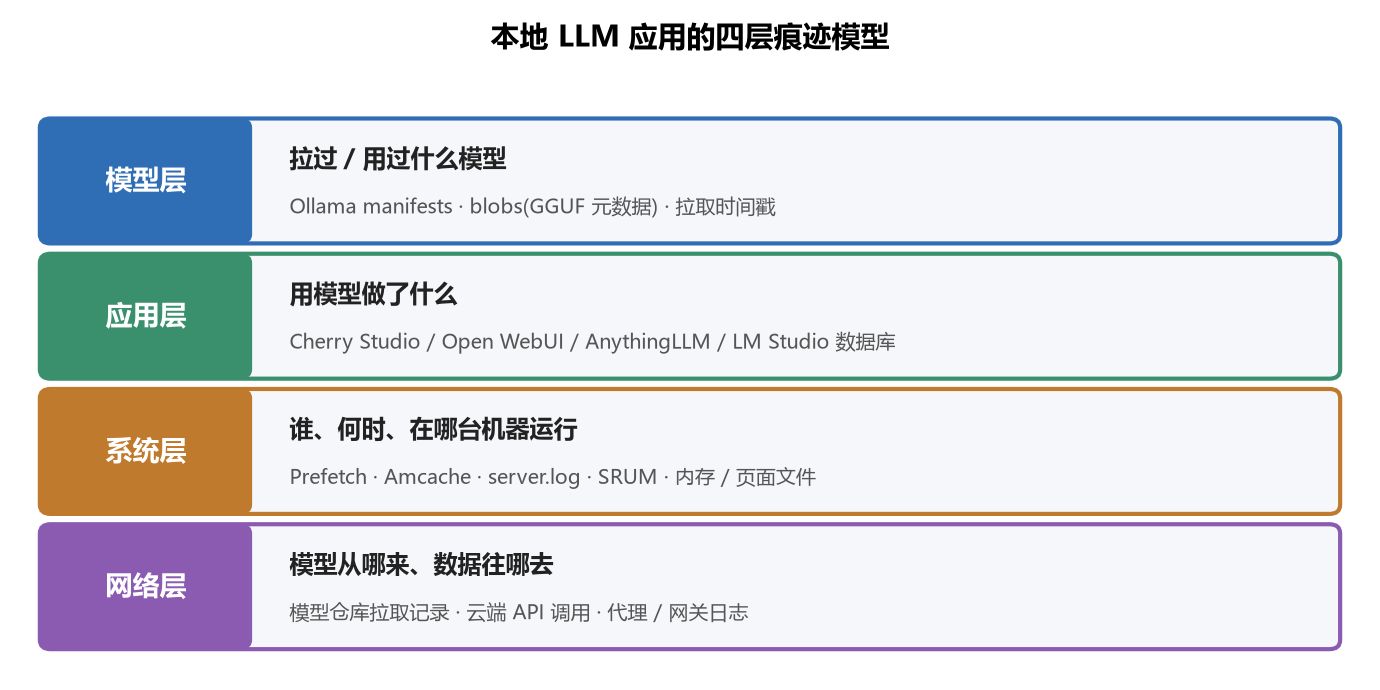
| 层 | 回答的问题 | 典型证据源 |
|---|---|---|
| 模型层 | 拉过(用过)什么模型? | Ollama manifests/blobs、GGUF 元数据 |
| 应用层 | 用模型做了什么? | Cherry Studio / Open WebUI / AnythingLLM / LM Studio 的对话库 |
| 系统层 | 谁、何时、在哪台机器跑过? | Prefetch、Amcache、server.log、SRUM、内存/页面文件 |
| 网络层 | 模型从哪来、数据往哪去? | 拉取日志、代理/网关日志、API Key 反查云端 |
四层相互印证才能形成完整链条:模型层告诉你“某个模型在何时被拉取”,应用层告诉你“几天后它生成了什么内容”,系统层告诉你“这些操作发生在本机本账户”,网络层则可能直接把线索引向云端。下面逐层展开。
二、Ollama:模型名单、时间与来源
Ollama 是最常见的本地模型运行时,Windows 下默认全部数据都在用户目录:
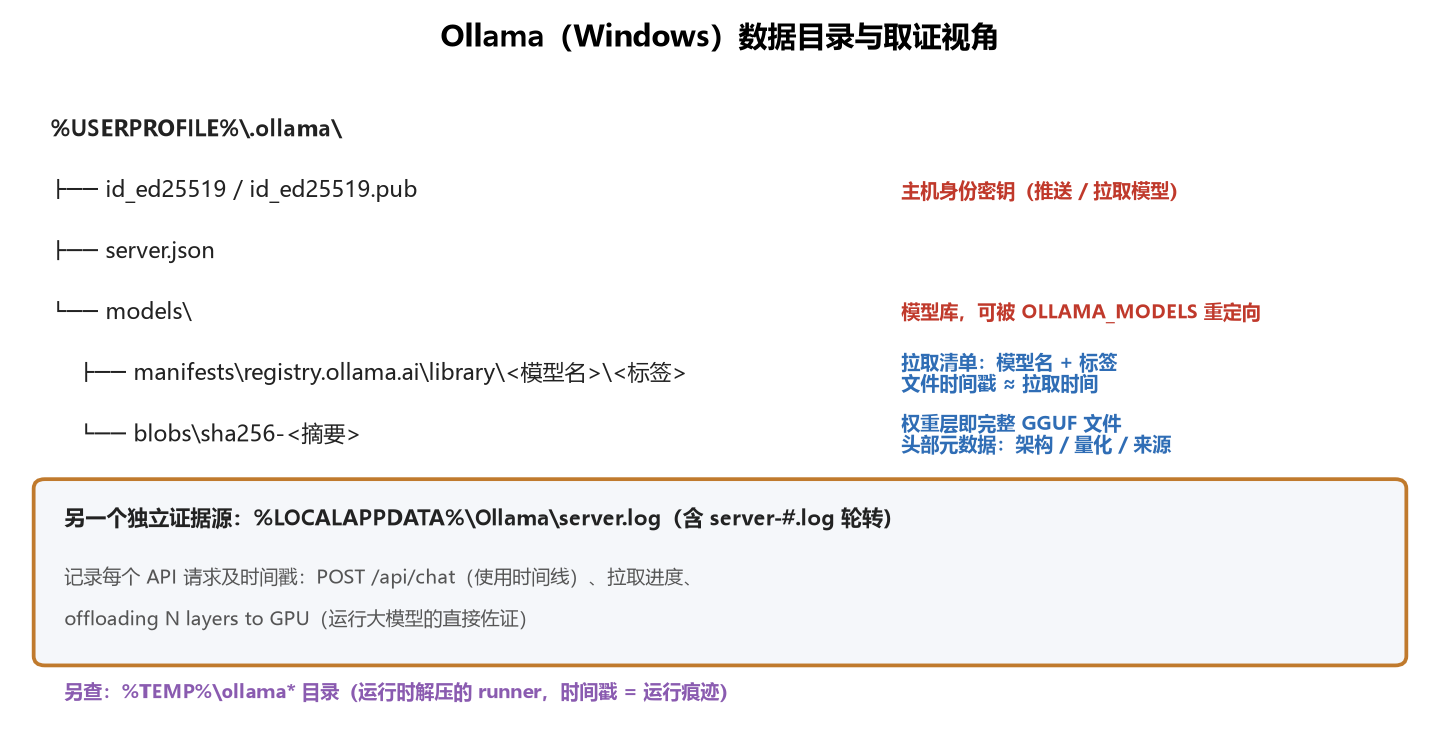
%USERPROFILE%\.ollama\
├── id_ed25519 / id_ed25519.pub   # 主机身份密钥(推送/拉取模型用)
├── server.json                    # 本地配置(如 disable_ollama_cloud)
└── models\
    ├── manifests\registry.ollama.ai\library\<模型名>\<标签>
    └── blobs\sha256-<摘要>
2.1 manifests:拉过什么模型,什么时候拉的
manifests 目录是“模型清单”:每个文件对应一次 ollama pull,文件名就是模型名和标签,例如 library\qwen2.5\14b。文件本身是小体积 JSON,记录 config 和各层(模型权重、提示词模板、许可证)的 SHA-256 摘要:
{
  "schemaVersion": 2,
  "config": { "digest": "sha256:aa14...", "mediaType": "application/vnd.docker.container.image.v1+json" },
  "layers": [
    { "digest": "sha256:bb22...", "mediaType": "application/vnd.ollama.image.model" },
    { "digest": "sha256:cc33...", "mediaType": "application/vnd.ollama.image.system" }
  ]
}
文件的最后修改时间 ≈ 模型拉取时间,是重建时间线的重要锚点。快速枚举:
    Get-ChildItem "$env:USERPROFILE\.ollama\models\manifests" -Recurse -File |
      Select-Object FullName, LastWriteTime, Length
注意:用户可通过
OLLAMA_MODELS环境变量把模型库重定向到其他盘。解析前先查HKCU\Environment和系统环境变量注册表项,否则容易漏检 D 盘、移动硬盘上的模型库。
2.2 blobs:把模型文件当物证,读出架构与来源
blobs 目录里按内容寻址存着所有层。其中 config 层是小 JSON,模型权重层本身就是完整的 GGUF 文件。GGUF 头部携带丰富的元数据,用 llama.cpp 官方的 gguf 工具直接解析:
pip install gguf
gguf_dump "C:\Users\xxx\.ollama\models\blobs\sha256-bb22..."
# 或:python -m gguf.scripts.gguf_dump <文件>
值得关注的键:
general.architecture/general.name/general.basename:模型家族与版本(llama3、qwen2…);general.file_type:量化等级(Q4_K_M 之类),可反映使用者对硬件和效果的取舍;general.size_label、general.license:规模与开源许可;general.source.url:部分新模型会记录原始 HuggingFace 仓库地址——直接给出下载来源;tokenizer.chat_template:对话模板,某些垂直微调模型的模板会暴露其预期用途(如特定语种的翻译模板)。
即使 manifests 被删除,只要 blobs 还在(甚至落在未分配空间),在文件中搜索 GGUF 魔数 GGUF(十六进制 47 47 55 46)即可 carve 出模型文件并恢复以上元数据。
2.3 server.log:Ollama 自己写的“行为日志”
%LOCALAPPDATA%\Ollama\server.log        # 最新
%LOCALAPPDATA%\Ollama\server-1.log ...  # 轮转的历史日志
日志以 GIN 框架格式记录每个 API 请求及时间戳:
[GIN] 2026/03/05 - 21:14:03 | 200 |  1.2s | 127.0.0.1 | POST  "/api/chat"
[GIN] 2026/03/05 - 21:14:09 | 200 | 0s | 127.0.0.1 | GET "/api/ps"三类高价值记录:POST /api/chat、/api/generate 的使用时间线(即使对话内容不落盘,“什么时候问了多少次”是硬证据);pulling manifest / 下载进度行的拉取记录;以及 offloading N layers to GPU 这样的加载行——这是“确实跑过大模型”的最直接技术佐证(比翻显卡驱动日志可靠得多)。
另外检查 %TEMP% 下的 ollama* 目录:运行时会解压 runner 可执行文件,其时间戳同样是“跑过”的印证。
2.4 关键提醒:Ollama 本身不保存对话内容
命令行 ollama run 的对话只存在于内存和日志的元信息里,不落盘。若对象纯用命令行交互,对话还原要靠系统层手法(见第七节:PSReadLine、内存镜像、页面文件)。但实务中绝大多数使用会通过带界面的客户端完成——那才是对话取证的主战场。
三、四类主流客户端:对话取证的主战场
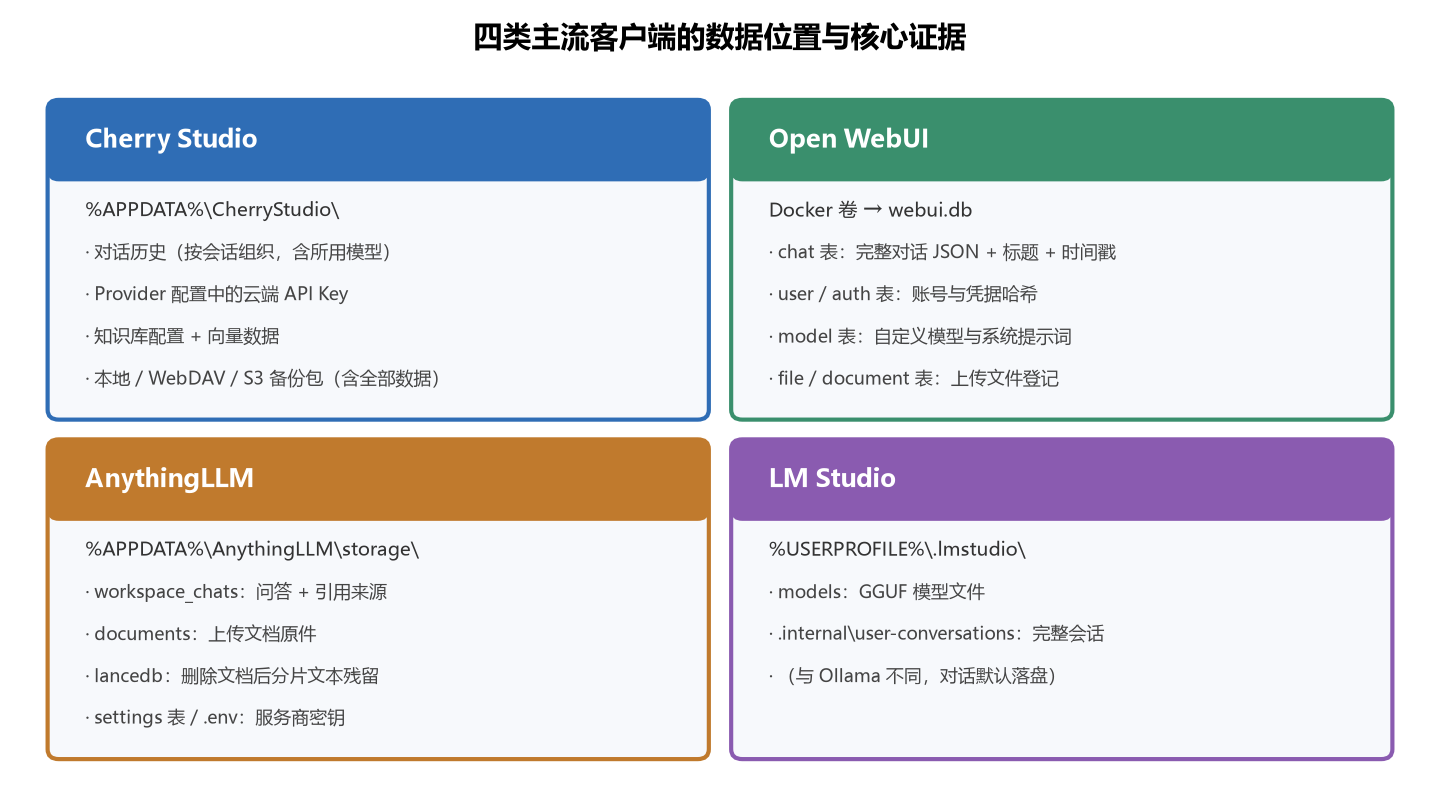
Ollama 之上,实际使用几乎都发生在客户端。四类主流客户端的数据位置与核心证据如下,后文逐一展开:
四、Cherry Studio:对话、密钥与知识库
Cherry Studio 是国内最流行的桌面 LLM 客户端之一,数据目录在:
%APPDATA%\CherryStudio\该应用迭代很快,不同版本的存储形态有差异:旧版把应用状态持久化在 Electron 浏览器存储(Local Storage\leveldb、IndexedDB)中,新版逐步迁移为独立数据库文件。现场处置建议按“三步走”:
- 枚举:
Get-ChildItem "%APPDATA%\CherryStudio" -Recurse -File,重点看*.db、*.sqlite*、Data、Local Storage、IndexedDB、Session Storage目录; - 识别:数据库文件用
sqlite3 <文件> ".tables"列表;leveldb 文件先用工具导出(或对.ldb/.log文件做字符串提取),里面是大段 JSON,按messages、topic、provider等关键字定位; - 解析:对话历史按会话(topic)组织,含角色、正文、时间戳、所用模型;知识库配置记录了向量化模型、分片参数和原始文档路径;Provider 配置里是各家模型服务商的 API Key。
两个高价值点:
API Key 是全局最值钱的单个证据。 Cherry Studio 的“本地”通常只是界面本地,推理往往调用 DeepSeek、通义、OpenAI 等云端 API。拿到 Key 之后,依法向服务商调取该 Key 的调用记录和服务端对话历史——即使本地删库,云端记录依然完整。这是击碎“离线=无痕”幻觉最有力的转向。
备份机制是“自首式”取证。 该应用内置本地备份与 WebDAV/S3 云备份,备份文件打包了对话历史、助手配置、知识库(含向量数据)和 Provider 配置。查到备份压缩包,等于一次拿到全部;查到 WebDAV 配置,还可以顺藤摸瓜到对应网盘账号。官方文档明确提示备份文件含 API Key、不可外传——反过来对办案人员,就是“一个包管到底”。
五、Open WebUI:Docker 卷里的 webui.db
Open WebUI 常以 Docker 部署,数据库固定在容器内 /app/backend/data/webui.db(SQLite)。在线处置:
docker ps                                  # 确认 open-webui 容器
docker cp open-webui:/app/backend/data/webui.db ./
离线处置(主机已关机):Docker Desktop 的数据在 WSL 虚拟盘里,定位 %LOCALAPPDATA%\Docker\wsl\(及旧版 docker-desktop-data 发行版)下的 ext4.vhdx,挂载后到 /var/lib/docker/volumes/open-webui/_data/backend/data/ 提取。
webui.db 关键表:
| 表 | 内容 |
|---|---|
chat |
核心。chat 列是一整段 JSON:所用模型、完整消息列表(含文件附件引用);title 是自动生成的会话标题;created_at/updated_at 为 Unix 秒级时间戳 |
user |
用户名、邮箱、角色、最后活跃时间 |
auth |
登录邮箱与 bcrypt 密码哈希(可支撑“同一人操作”的认定) |
model |
自定义模型配置,含系统提示词(system prompt)——往往直接暴露用途 |
file / document |
上传文件与知识库文档的登记记录 |
常用导出:
SELECT id, user_id, title, datetime(created_at,'unixepoch','localtime')
FROM chat ORDER BY created_at;
再按 id 取出 chat 列 JSON 还原全文。注意两点:时间戳是 UTC,换算北京时间别差 8 小时;SQLite 的 -wal 文件里常有尚未合并进主库的最新记录,务必连同 webui.db-wal 一起提取。
六、AnythingLLM:还原“喂过什么文档”
AnythingLLM 主打“知识库问答”,桌面版数据目录:
%APPDATA%\AnythingLLM\storage\
├── anythingllm.db     # SQLite 主库
├── documents\         # 用户上传的原始文档
├── lancedb\           # LanceDB 向量库(每个工作区一个 .lance 目录)
└── .env               # 部分密钥/配置(另一些在库内 settings 表)
取证价值逐个说:
workspace_chats表:prompt、response两列就是一问一答,response是 JSON,除正文外还带引用来源(sourceDocument)——直接把回答关联到上传的某个文档;workspace/documents表:工作区划分(可反映使用分工)与文档登记;documents\目录:上传原件原样保留,Word、Excel、PDF 直接出——“喂给 AI 的资料长什么样”一目了然;lancedb\:最容易被忽视的金矿。文档被切块向量化后存进 LanceDB,即使事后从工作区删除了文档,向量库里的分片文本往往仍在。.lance目录内文件用字符串提取即可捞出大量原文片段,足以还原文档内容轮廓。
七、别漏了 LM Studio
LM Studio 是另一个主流桌面端,与 Ollama 不同的是它会完整保存对话。检查:
%USERPROFILE%\.lmstudio\
├── models\                     # GGUF 模型文件
└── .internal\user-conversations\   # 会话记录(JSON)与向量数据
对话按会话 JSON 存储且不加密,直接可读。实务中经常出现多个工具混用的情况:Ollama 跑模型 + Cherry Studio 聊天 + LM Studio 调试,四套证据源一个都不能省。
八、系统层与网络层:没有专门应用也要查的通用手法
8.1 执行痕迹
- Prefetch(
C:\Windows\Prefetch\):OLLAMA.EXE-*.pf、CHERRY STUDIO.EXE-*.pf、LM-STUDIO.EXE-*.pf、LLAMA-SERVER.EXE-*.pf等,运行次数与最近运行时间直接可读; - Amcache(
C:\Windows\appcompat\Programs\Amcache.hve):完整安装路径与文件版本——Ollama 的版本号有助于确定涉案时段该版本的行为特征; - UserAssist / JumpLists / RecentDocs:GUI 应用的启动记录;
- PSReadLine(
%APPDATA%\Microsoft\Windows\PowerShell\PSReadLine\ConsoleHost_history.txt):最容易被忽略的对话金矿。使用者若曾在 PowerShell 里执行ollama run qwen2.5:14b "把这份名单按地区分组",整条命令连同提示词原文就躺在这里。
8.2 内存与页面文件
Ollama 的对话上下文、KV cache 都在内存/显存中。对仍在运行或使用休眠的设备,先做内存镜像;在镜像和 pagefile.sys/hiberfil.sys 中搜索:
- GGUF 魔数与模型名(判断加载过的模型);
- 案件关键词、目标文本片段(对话内容残留)。
技术提示:llama.cpp 的 KV cache 默认在内存,只有显式启用提示词缓存参数时才会写盘文件,不要指望在磁盘上直接找到“cache 文件”——正确姿势是内存镜像 + 页面文件。
8.3 网络侧
- SRUM 数据库(
C:\Windows\System32\sru\SRUDB.dat):按应用统计的网络用量。某天ollama.exe突然产生 4.7 GB 下载——那就是一次模型拉取,时间点都有了; - 网关/代理/防火墙日志:
registry.ollama.ai、huggingface.co的拉取请求,api.deepseek.com、api.openai.com等 API 调用(配合客户端里的 Key 形成完整证据闭环)。
九、现场速查表
| 检查对象 | 路径 | 能回答什么 |
|---|---|---|
| Ollama 模型清单 | %USERPROFILE%\.ollama\models\manifests\ |
拉过什么模型、何时拉的 |
| Ollama 模型文件 | ...\models\blobs\(GGUF) |
模型架构、量化、下载来源 |
| Ollama 日志 | %LOCALAPPDATA%\Ollama\server*.log |
使用时间线、GPU 加载、拉取记录 |
| Cherry Studio | %APPDATA%\CherryStudio\ |
对话历史、API Key、知识库配置、备份包 |
| Open WebUI | Docker 卷 webui.db |
完整对话 JSON、用户、系统提示词 |
| AnythingLLM | %APPDATA%\AnythingLLM\storage\ |
问答记录、上传文档原件、向量库残留 |
| LM Studio | %USERPROFILE%\.lmstudio\ |
GGUF 模型 + 完整会话记录 |
| 执行痕迹 | Prefetch / Amcache / UserAssist | 谁在何时运行过这些程序 |
| 命令历史 | PSReadLine ConsoleHost_history.txt |
命令行交互的提示词原文 |
| 网络用量 | SRUM / 网关日志 | 模型拉取、云端 API 调用 |
十、办案提示
- 先镜像后解析。所有数据库都按“镜像优先、只读挂载、原样提取
db/db-wal/db-shm三件套”处理; - 删了也未必没了。模型文件可按 GGUF 魔数 carving;向量库的分片文本是“删除后残留”的重灾区;备份包和云端(WebDAV、模型服务商)是两条独立的恢复路径;
- 注意重定向与便携版。
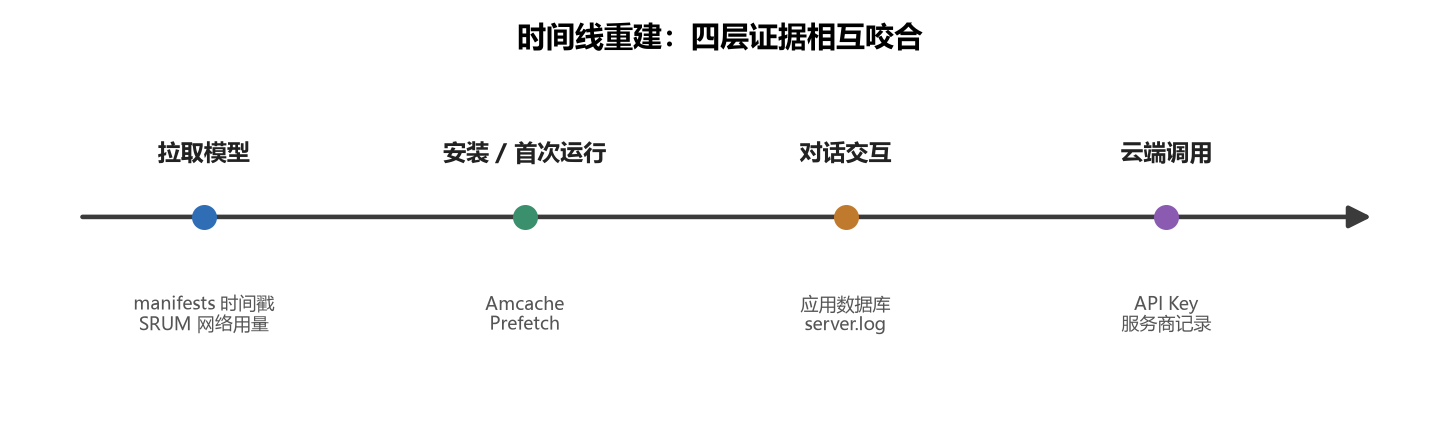
OLLAMA_MODELS环境变量、客户端自定义存储位置、U 盘便携版(结合 USBSTOR 与 Prefetch 判断)都可能让数据不在默认路径; - 时间线要把四层证据串起来。拉取 → 安装 → 交互 → 云端调用,每一环都有独立证据源,互相咬合的证据链远比单点记录有力:
- 版本差异写进勘验笔录。这类应用迭代极快,文中路径以写作时点的常见版本为准,现场以“先枚举、再识别、后解析”的方法论应对变化。
结语
大模型应用把“离线即无痕”的认知误区推到了顶点,但从取证视角看,它反而是记录最勤快的应用类型之一:模型文件自带“简历”,客户端数据库记着“聊天记录”,系统日志写着“出勤表”,网络日志留了“通话清单”。对习惯了文件与数据库取证的我们来说,工具不变、套路不变,变的只是对象——而这恰恰是电子数据取证最熟悉的战场。
欢迎在办案中遇到新型 AI 应用痕迹的同仁补充实测样本与版本差异,共同完善这份检查清单。
评论
评论区尚未启用。
这是一个可插拔占位。启用时只需修改
src/components/Comments.astro顶部的provider常量并填入配置,站点其他部分无需改动。站点当前处于纯静态模式:无数据库、无服务端运行时。 接入评论系统会引入一个外部依赖(GitHub 或自托管服务), 具体取舍见该组件顶部的注释。